데이터양은 얼마 안 되는데 Spark 조회만 느립니다. 어디를 봐야 원인이 나오고, 고친 뒤에는 무엇이 남을까요?
왜 필요한가
모델 학습 관련된 작업을 하던 중 학습과 추론 과정에서 소요시간이 너무 길게 잡히는 것을 확인했습니다.
물론 학습에 필요한 데이터가 많기 때문에 어쩔 수 없이 오래 걸리는 건 당연하다고 생각했죠
하지만 내가 생각했던 데이터량 대비 소요시간이 너무 길어 해당 현상을 조사하기 시작했습니다.
우선 문제가 되는 API(학습 및 추론)의 소요시간을 측정해보기 시작했습니다.

학습 데이터 조회를 위해 약 10억 정도의 데이터를 조회하는 경우 위와같이 시간이 오래 걸리는것을 확인하게 되었다
해당 글은 원인 확인을 위해 내가 확인했던 방법과 어떻게 해결하는지에 대한 과정을 담아 다른사람에게도 좋은 인사이트가 됬으면 좋겠다는 마음으로 정리를 진행했습니다
Spark UI 부터 연 이유
브레이크 포인트는 최후의 수단이라고 생각합니다
저는 코드에 브레이크 포인트를 찍어가며 디버깅하는 것은 최후의 수단이라고 생각합니다.
왜냐하면 해당 방식으로 디버깅할 수 없는 상황(운영 환경)이 분명히 올 수도 있고, 문제점은 간단하게 모니터링 및 계측을 통해서 확인이 돼야 한다고 생각하기 때문입니다.
만약 그러한 도구를 지원하지 않는다면 코드 안에 직접 기능들을 넣어서 계측할 수 있는 간이 페이지를 만들곤 합니다.
물론 어쩔 수 없이 코드단을 훑어봐야 하는 경우에는 코드 디버깅을 하는 편입니다. 다만 Spark에서는 잘 되어있는 모니터링 및 계측 도구들을 지원해주기 때문에 우선 모니터링을 해보기로 했습니다.

해당 화면에서는 Job의 상태를 확인할 수 있습니다.
우선 코드 내부에서는 Spark로 집계, 데이터 전처리, 특징벡터 생성 등이 이루어집니다. 코드 대부분이 Spark로 되어있기 때문에 해당 웹 UI를 보는 게 더 빠를 거라고 생각했습니다.
Spark를 이용해서 집계, 데이터 전처리를 하는 경우에는 코드 디버깅만으로는 판단하기가 어렵습니다. 지연 계산(lazy evaluation) 이라서 코드를 거치는 순간 바로 처리되지 않기 때문입니다.
보통 map, filter, select, join 같은 명령어는 DAG(설계도)에만 쌓아두고 실행은 하지 않습니다. 그러다가 action(count, collect, show 등)이 호출되는 순간 runJob()을 통해서 Job으로 올라가곤 합니다.
그러면 해당 화면에서 Job 목록, 상태, Stages, 실행계획(DAG) 등을 파악할 수 있게 됩니다.
물론 Spark를 사용하지 않는 non-Spark 로직은 해당 화면으로 파악할 수 없지만, 코드 대부분이 Spark 연산을 통해서 이루어지기 때문에 모니터링 화면을 보는 게 더 빠를 거라고 생각했습니다.
Spark 실행은 네 계층으로 쪼개집니다
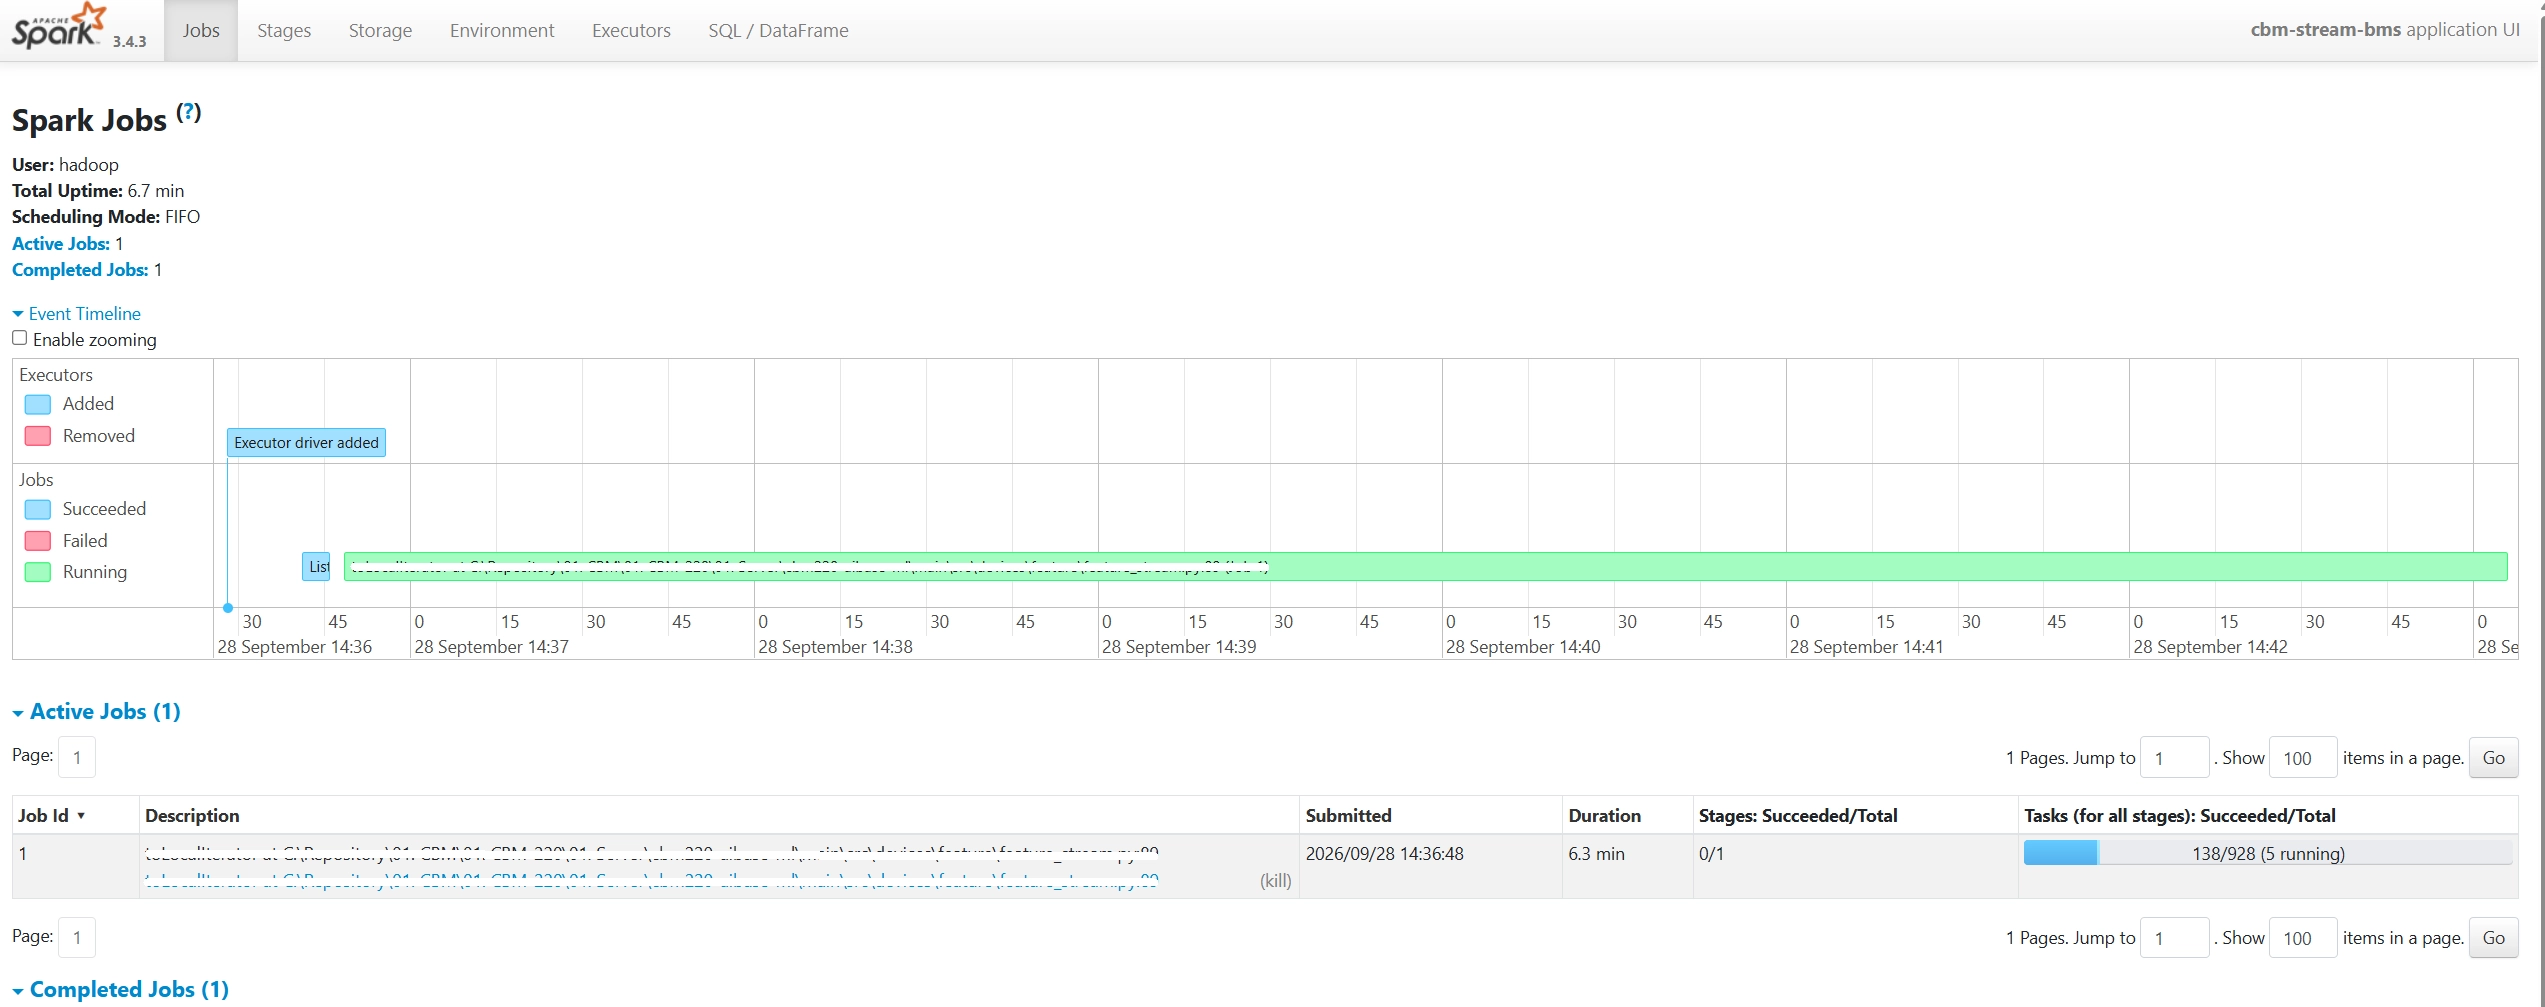
모니터링을 계속 진행하니 Tasks 쪽에서 Spark 연산이 오래 걸리는 것을 확인할 수 있었습니다.
Tasks는 Spark 실행의 최소 단위로서, action 함수가 진행될 때 지금까지 쌓인 DAG를 파티션 1개에 적용해서 코어 1개가 돌리는 작업입니다.
한마디로 Tasks가 928이면 코어 개수에 따라서 해당 태스크들을 병렬처리해서 돌리게 됩니다.
Task 안에는 Stage의 연산 파이프라인을 직렬화한 클로저와 파티션 위치정보들이 들어가 있습니다.
정리해보자면 Spark 실행은 아래 계층으로 쪼개집니다.
Application (앱 하나)
 └─ Job      ← action 1개가 트리거 (runJob 호출)
     └─ Stage    ← 셔플(shuffle) 경계로 분할
         └─ Task    ← 파티션(partition) 수만큼 생성
Job은 action이 호출하는 실행의 단위입니다. 앞에서 말했듯이 map, filter, select, join 같은 코드는 DAG에만 쌓이고 실행되지 않습니다.
그리고 count, collect, show, write 같은 action이 호출되는 순간 runJob()이 불려 Job이 제출되는데, 그게 위에서 본 화면입니다. 한마디로 action은 Job 트리거라고 볼 수 있습니다.
Stage 와 Task 는 이렇게 나뉩니다
그다음 Job을 데이터 재분배(셔플)가 필요한 부분마다 Stage 형태로 자릅니다.
Stage로 자르는 이유는 데이터가 흩어져 있기 때문입니다. HDFS에서는 데이터를 블록 단위로 쪼개서 저장하는데, 그러면 클러스터 전체에 서로 다른 데이터가 퍼져 있는 상태가 됩니다.
이 상태에서 groupBy나 join처럼 다른 곳에 있는 데이터를 불러오려면 셔플이라는 작업을 거치게 되는데, 이 셔플 경계로 Stage가 나뉜다고 보면 됩니다.
Stage는 셔플 없이 이어 돌릴 수 있는 연산 구간이라고 보면 됩니다. 셔플 경계로 끊긴 하나의 Stage 안에서는 Task들이 쪼개져서 병렬처리가 됩니다. Task를 모두 처리하면 다음 Stage로 넘어가게 됩니다
.
Task는 Spark의 최소 단위로서, Stage를 파티션 수만큼 복제한 것이라고 보면 될 것 같습니다. 보통 파일을 읽는 과정을 거치고 크기에 맞춰서 Task가 쪼개집니다. 그리고 할당된 Spark 코어 수만큼 병렬로 처리됩니다. 코어가 4개면 4개씩 Task가 처리되는 식입니다.
같은 지표를 두 가지로 나눠 읽기
DAG 상세는 Job 의 X-ray 입니다
Spark 연산에서 생기는 병목현상을 확인하기 위해 직접 DAG를 확인해봤습니다.
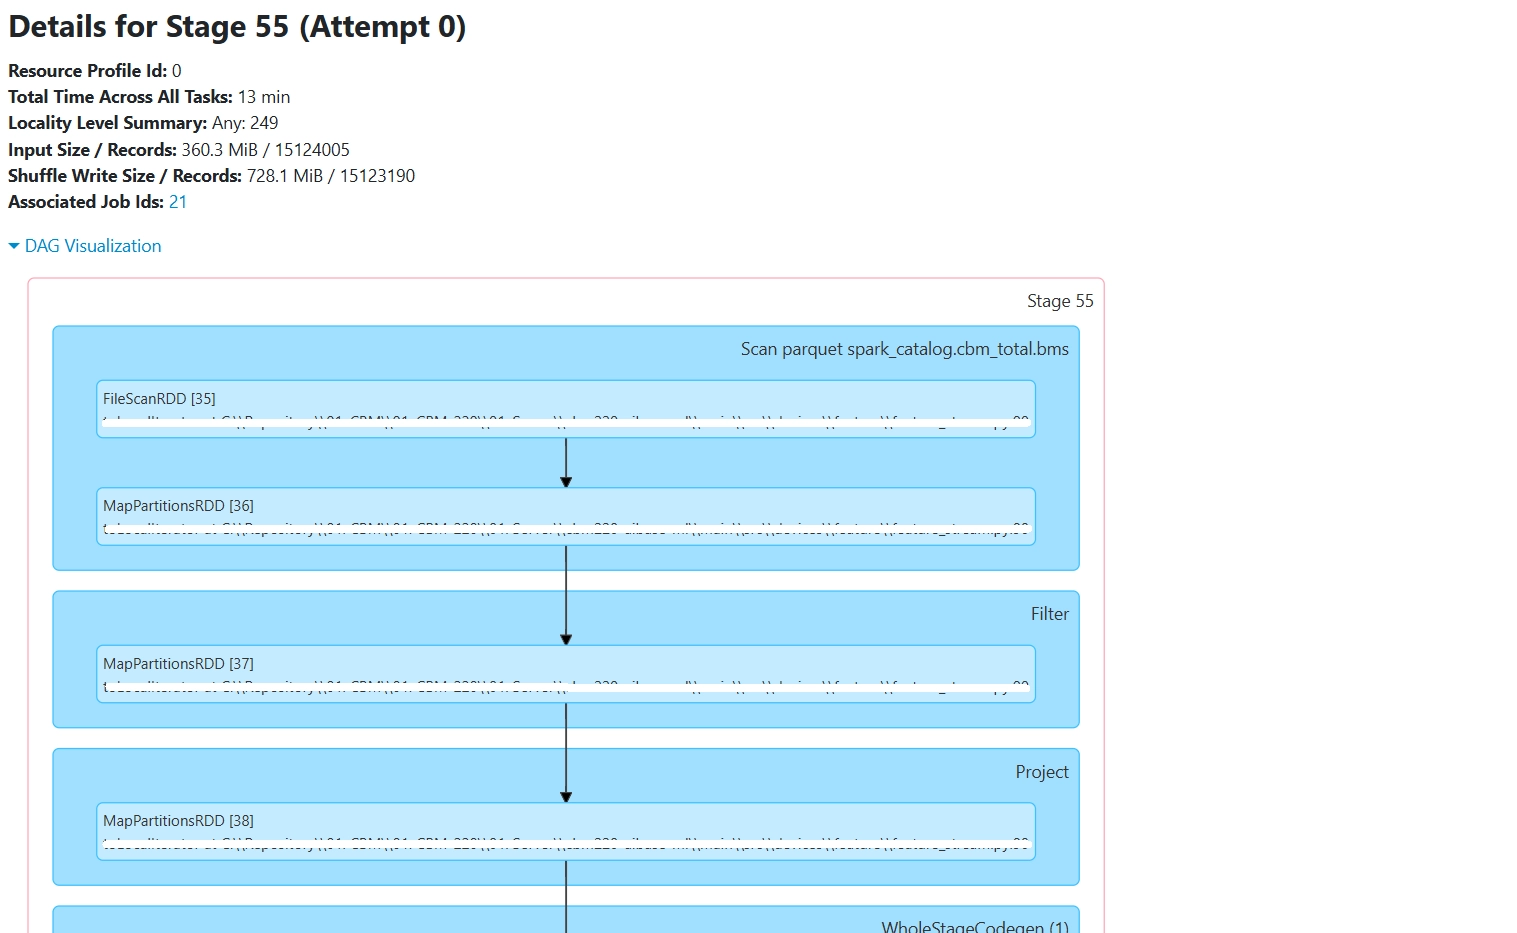
Job의 상세 DAG를 클릭하면 해당 Job들이 뭘, 얼마나, 어떻게, 어디서 작업 중인지 알 수 있습니다.
Job에 할당되어 있는 데이터 스큐, 메모리, 셔플 비용, 파티션 크기 등등을 투명하게 볼 수 있는 Spark Job X-ray 라고 보면 될 것 같습니다.
Jobs 탭      →  어느 Job 이 오래 걸리나
  Stages     →  Input Size / Records, Task 수
    DAG 상세  →  스큐 · 메모리 · 셔플 비용 · 파티션 크기
      SQL 탭  →  읽은 파일 개수와 크기
레코드가 작다는 건 나쁜 신호가 아니었습니다
Stage 상세를 보면 Input Size / Records: 360.3 MiB / 15,124,005 이렇게 찍힙니다.
처음엔 "입력이 360MB밖에 안 되는데 왜 이렇게 오래 걸리지?" 싶었습니다.
그런데 이 지표는 어떻게 나누어 보느냐에 따라 전혀 다른 두 가지 이야기를 합니다.
그것을 구분하고 나서야 이 값이 왜 문제인지 보였습니다.
먼저 레코드 단위로 나눠보면 행 하나가 약 25 bytes 수준입니다. 처음에는 "레코드가 너무 작아서 비효율적인가?" 싶었지만, 생각해보면 센서 데이터는 원래 행 하나가 숫자 몇 개짜리라 가벼운 게 정상입니다.
즉, 레코드가 작다는 건 나쁜 신호가 아닙니다. 오히려 이 수치는 이 잡의 진짜 부담이 용량(MB)이 아니라 행 수(1,500만)에 있다는 걸 말해줍니다.
태스크 하나가 1.5MB 를 처리하고 있었습니다
이 Stage는 태스크가 928개인데, 입력 360MB를 928개로 나누면 태스크 하나가 겨우 1.5MB를 처리합니다.
Spark가 파티션 하나를 약 128MB로 잡는 걸 목표로 하는데, 그 기준에 한참 못 미칩니다.
즉, 데이터를 지나치게 잘게 쪼개 생긴 과다 파티션(over-partition) 상태입니다.
과다 파티션이 안 좋은 이유는 태스크 하나를 돌릴 때마다 스케줄링·직렬화 같은 고정 오버헤드가 붙기 때문입니다. 1.5MB짜리 작업에 그 오버헤드가 붙으면, 실제 계산보다 부대비용이 더 커집니다. 그걸 928번 반복하니 오버헤드가 너무 많이 쌓일 거라고 생각이 됐습니다.
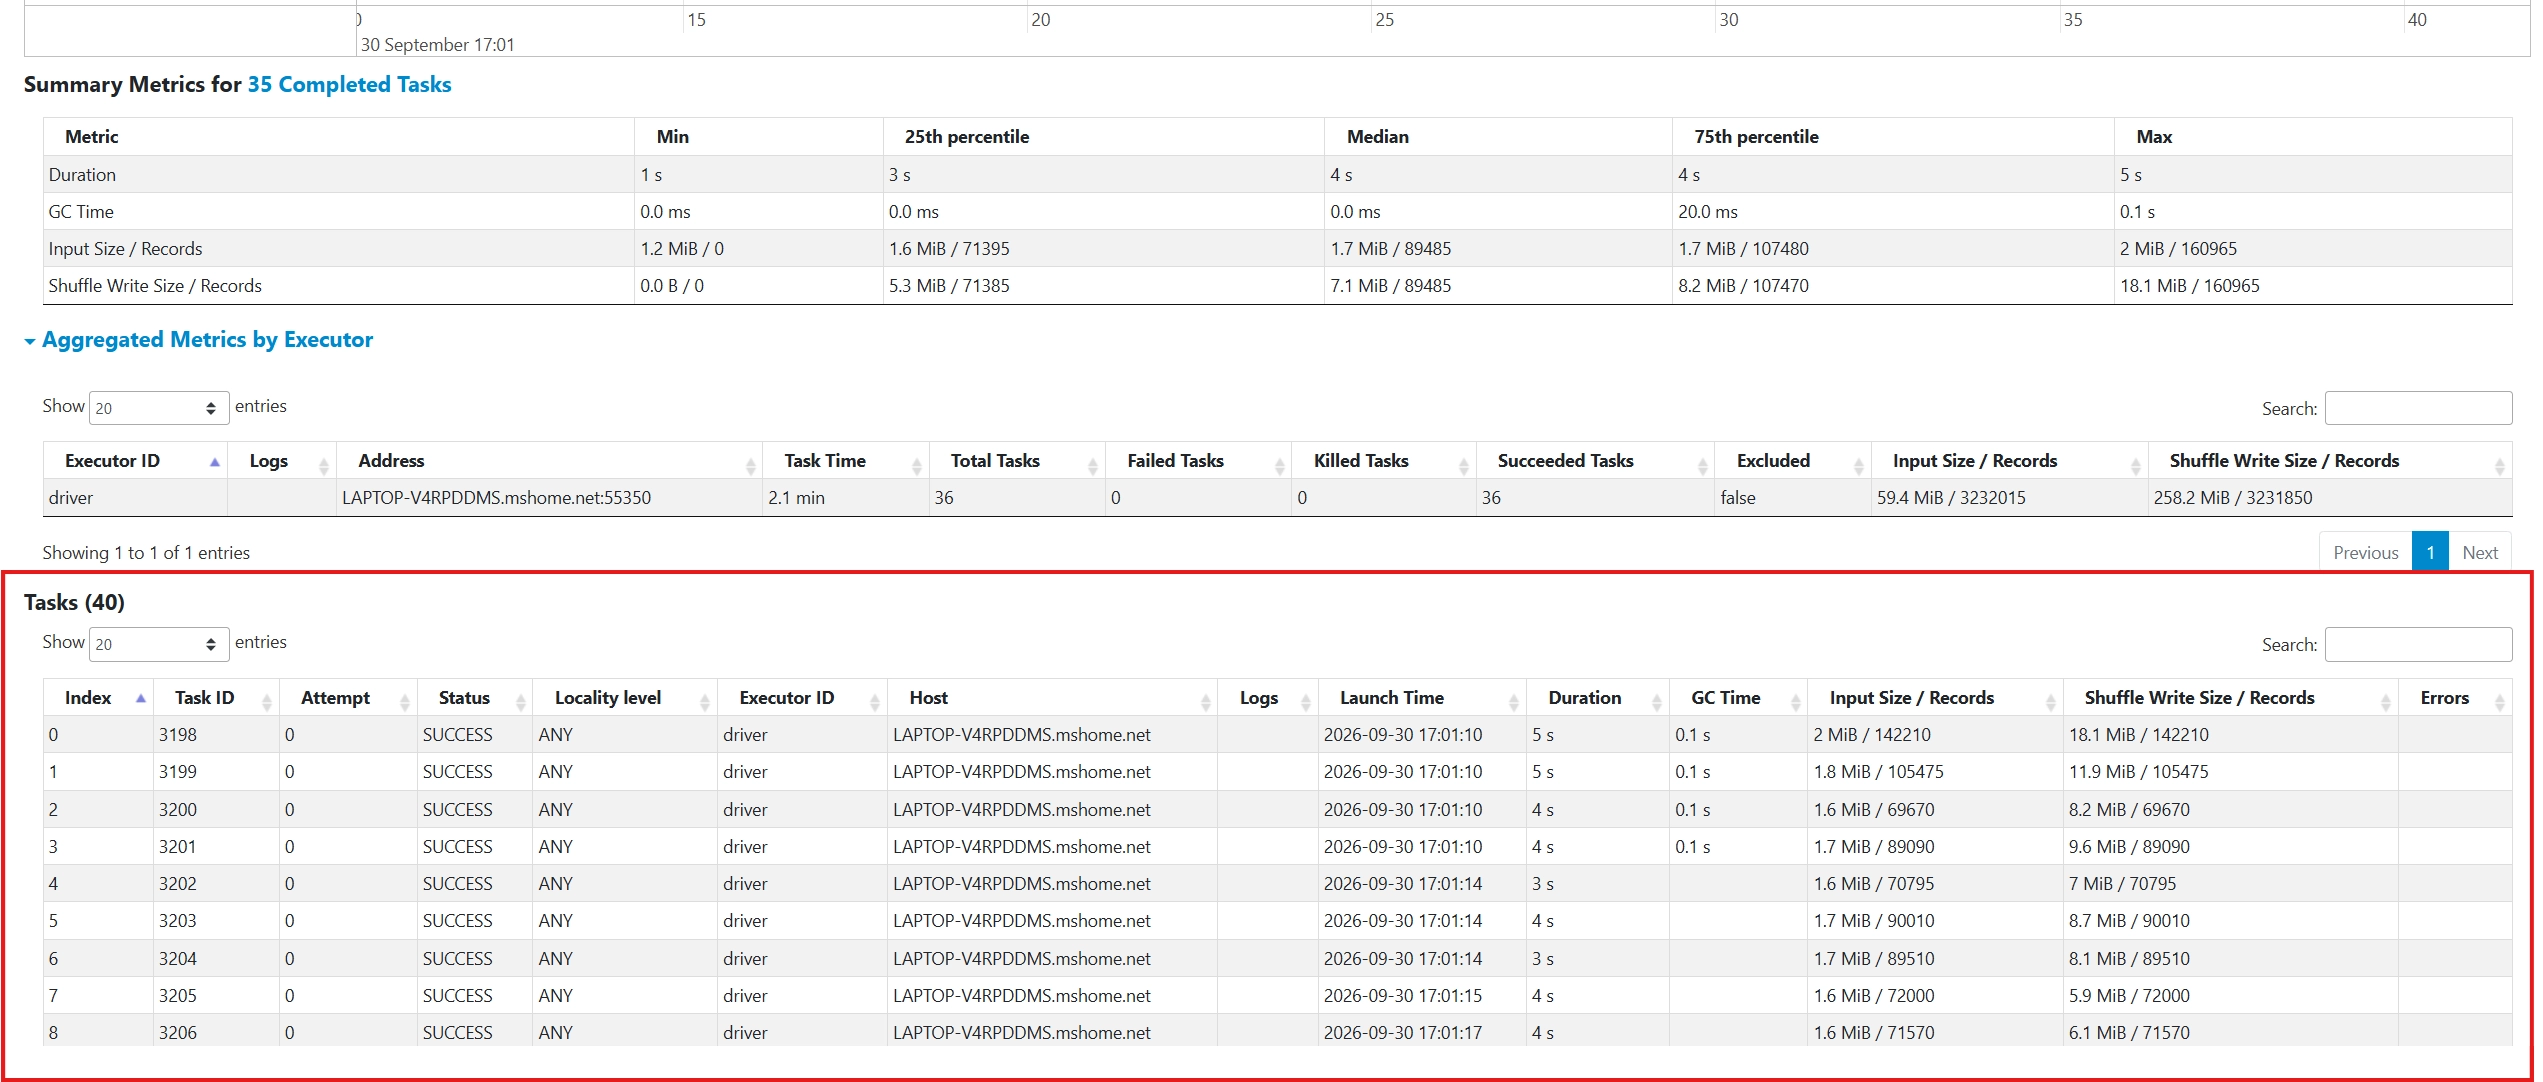
Stages 아래로 내려보니 제가 생각한 부분이 얼추 맞겠다는 확신이 생겼습니다. 빨간 박스 친 부분에서 Input Size를 보니 태스크 하나당 1.8MB 정도밖에 처리하지 않고 있는 걸 확인했습니다.
왜 이렇게 태스크 하나당 Input Size가 낮게 잡힐까요? 실제 쿼리에서 조회하는 데이터 정보를 보기로 했습니다.
진짜 원인과 적재 전략
파티션 하나에 파일이 86개였습니다
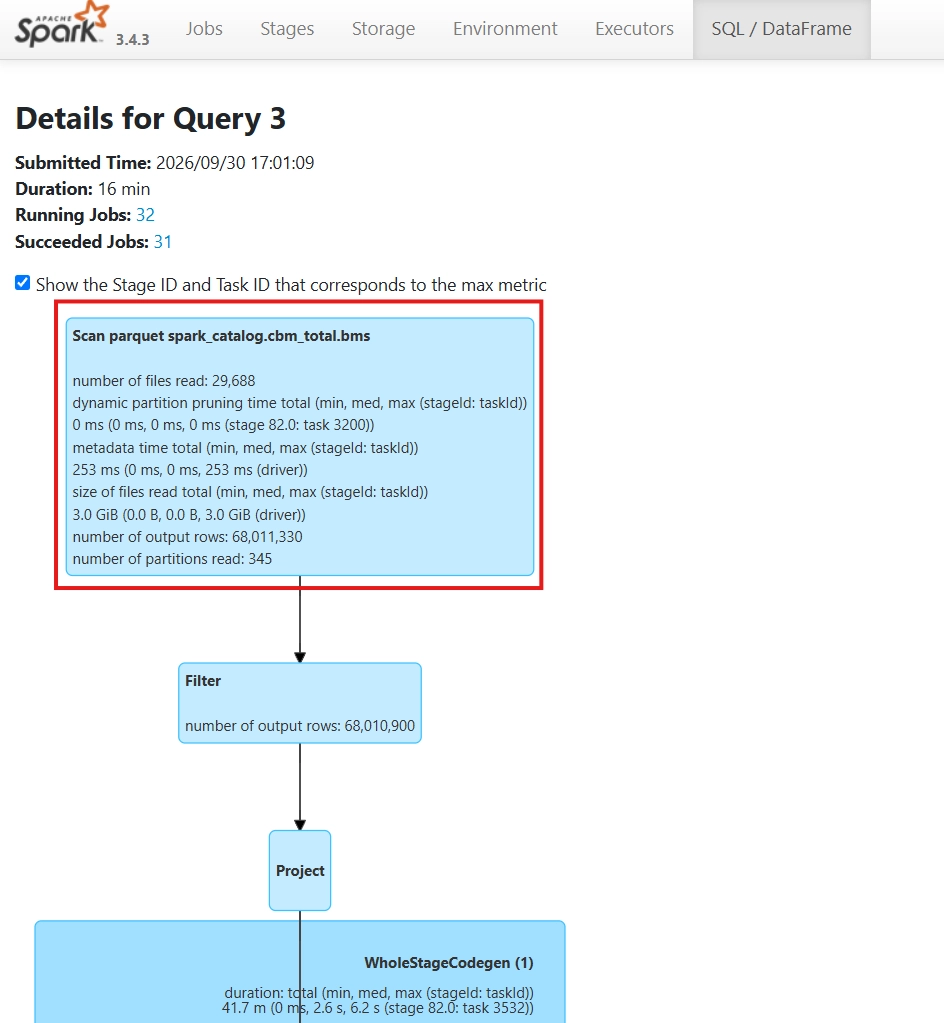
SQL / DATAFRAME 탭에서는 쿼리가 읽은 파일 개수와 크기를 직접 확인할 수 있습니다. 그리고 흥미로운 부분을 발견했습니다.
Scan parquet spark_catalog.cbm_total.bms
number of files read      = 29,688
size of files read        = 3.0 GiB
number of output rows     = 68,011,330
number of partitions read = 345
metadata time             = 253 ms
여기서 지표를 계산해보면 원인이 명확해집니다.
| 지표 | 계산 | 결과 |
|---|---|---|
| 파일당 크기 | 3.0GiB ÷ 29,688 | 약 106 KB — 초소형 파일 확정 |
| 행당 크기 | 3.0GiB ÷ 6,800만 행 | 약 47 bytes — 부담은 행 수 |
| 파티션당 파일 수 | 29,688 ÷ 345 | 약 86개 — 진짜 문제 |
현재 HDFS에는 파티션으로 데이터를 나누어 놓았습니다. 그런데 한마디로 파티션 하나에 파일이 86개나 들어가 있었습니다. 그러면서도 파티션당 데이터 크기는 68M ÷ 345 ≈ 197K행 × 47B ≈ 9MB, 겨우 9MB밖에 안 됐습니다.
보통 파티션 하나의 크기를 128MB로 잡고는 하는데, 그에 턱없이 못 미치는 9MB 데이터가 무려 86개로 쪼개져 있는 것을 확인할 수 있었습니다. 그렇기 때문에 쓸데없는 네트워크 통신 및 오버헤드가 발생한 것이었습니다.
근본적으로는 작은 사이즈의 데이터들이 파편화된 채로 적재된 게 문제라고 생각했습니다. 그래서 읽어들이는 데이터량 대비 태스크가 너무 많이 발생했던 것입니다.
이에 따라 파티션 안의 데이터를 하나로 뭉쳐서 적재하는 작업이 우선순위라고 판단했습니다.
병합 전후를 재서 확인했습니다
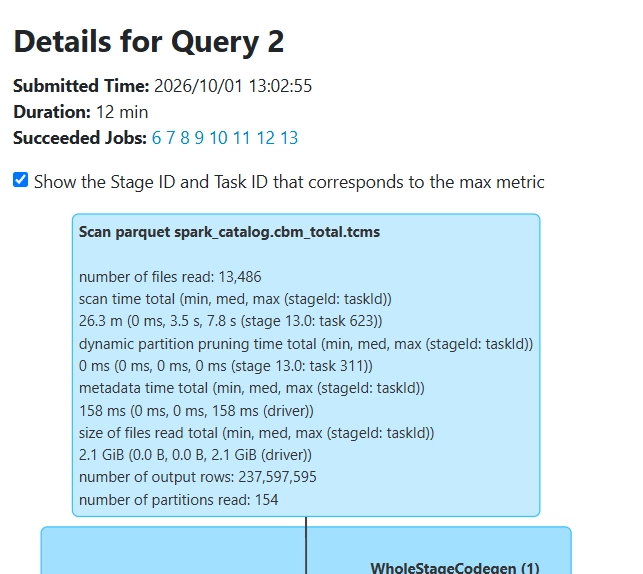
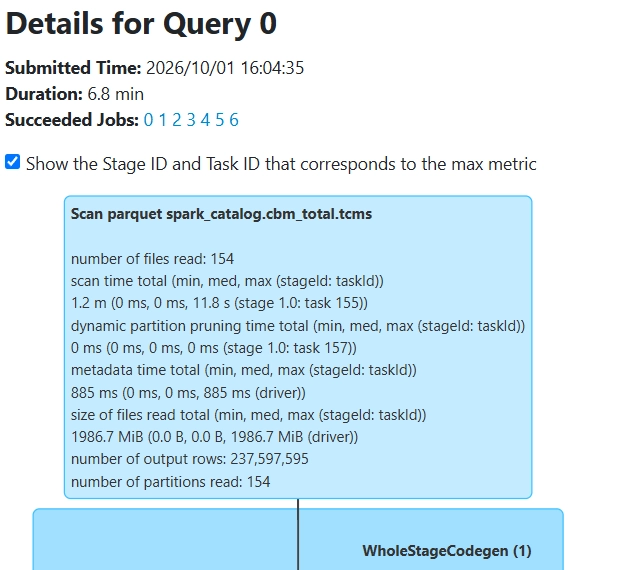


우선 스크립트를 만들어서 특정시간대의 데이터를 병합전, 병합후로 나눠 읽어들이는 속도를 측정해보았습니다.
실제로 읽는속도가 변화한것을 확인했으며, "데이터가 잘게 파편화된 채로 적재되어 있었다" 라는게 성능에 실제로 영향을 주고 있다는 걸 스캔 지표로 확인했습니다.
| 조건 | 소요시간 |
|---|---|
| Small Size 상태 | 10분 이상 |
| 과다 파티션 병합 후 | 약 6~7분 |
대략 2억 개 이상의 데이터를 조회했을 때 기준입니다.
수신·적재는 못 바꾸니 적재 이후를 바꿉니다
원인에 따른 해결방법을 어느정도 확인한뒤 적용하려고 하니 문제점이 있었습니다.
수신과 적재 프로세스 자체를 바꿀수 없었다는 것이었습니다.
데이터를 받자마자 바로 화면에 표현해줘야 하기 때문에, 수신 데이터를 모아놨다가 저장하면 실시간성의 의미가 퇴색되기 때문입니다.
그렇다면 적재가 다 된 뒤에 데이터를 다시 조정해줄 필요가 있다고 생각했습니다.
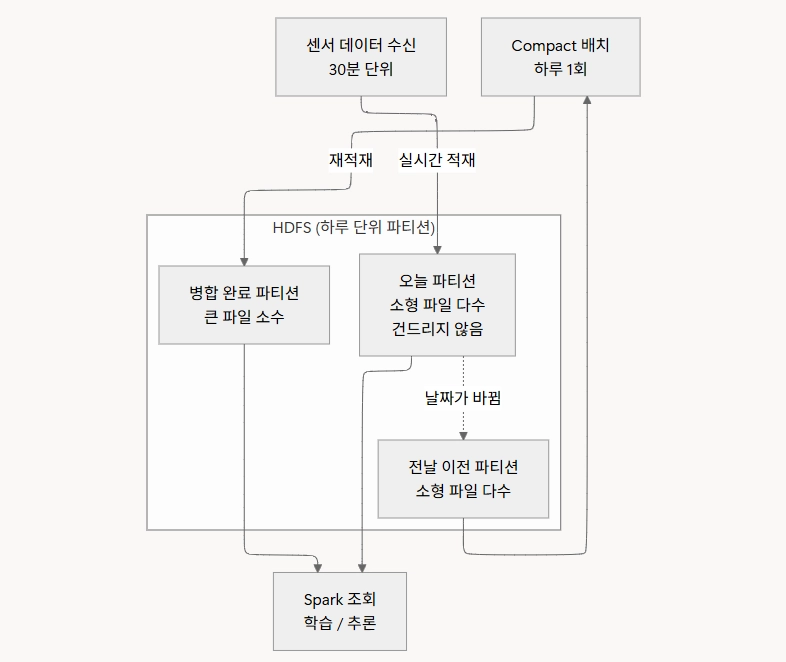
오늘자로 들어온 데이터는 계속 적재되게끔 하되, 과거 데이터는 모두 정해둔 포맷대로 compact 하는 작업으로 결정했습니다. 현재 HDFS는 하루를 단위로 파티션이 되어있기 때문에, 하루가 지나면 전날 파티션 안에 있는 파일들을 compact 하는 것이 좋다고 생각했습니다.
물론 하루치를 모두 compact 해도 분산처리로 많은 이득을 볼수있을만한 데이터 사이즈는 안나오기 때문에, 어디까지 파티션 병합을 진행할지는 팀원들과의 회의를 통해서 결정하기로 했습니다.
스크립트 compaction 의 구멍
앞의 compaction 작업은 결국 "소형 파일을 하나로 뭉쳐 다시 적재"하는 일이었습니다. 그런데 이걸 스크립트로 직접 하다 보니 문제점이 있었습니다.
첫번째로 파일을 지우는 순간 그 파일을 읽던 잡이 깨질 수 있다는 것입니다.
실제로 운영단계에서 compact 작업을 사람들이 많이 사용하지않는 시간대에 작업한다고 해도, 인식한 문제를 그냥 둘수는 없었습니다.
두번째로 옛 파일을 지우고 새 파일로 바꾸는 사이에는 조회 결과가 아예 비어버린다는 것입니다.
해당 문제로 인해 에러가 나지않고 그냥 빈 결과를 응답하기 때문에, 학습 데이터가 조용히 빠진채로 모델이 돌아가도 알수가 없었습니다.
물론 그렇다면 일주일 전 데이터를 compact 하면 되지만 근본적인 해결은 안 됐습니다.
오픈테이블 포맷 라이브러리는 무엇을 다르게 하는가
현재 프로젝트와 어울리는 라이브러리는?
어떻게 하면 안정적으로 compact 작업을 이루게 할수있을까? 라는 고민을 하던도중 Iceberg라는 라이브러리를 알게 되었다
Iceberg는 한마디로 parquet 파일 더미를 진짜 데이터베이스 테이블처럼 다루게 해주는 규약이며, HDFS 위에 Iceberg 계층을 추가해서 실제 데이터의 메타데이터를 따로 저장하고 그걸 통해 읽어들이는 것입니다.
또한 같은 문제를 푸는 오픈 테이블 포맷이 몇 개 더 있어서 같이 검토해봤다.
Delta Lake, Apache Hudi, Apache Paimon 등등 여러 라이브러리에 대한 특징들을 알아보기 시작했다
검토전 내가 해당 프로젝트에 적용하기 위해 중점적으로 볼것은 다음과 같았다
현재 운영중인 프로젝트이기 때문에 기존에 있던 데이터를 안정적이게 compact 할수있는지
우선 Apache Hudi는 레코드 키 기반 upsert와 중복 제거가 핵심 강점인 라이브러리인데 해당 라이브러리가 나온 배경을 보면 현재 내가 하는 프로젝트와는 결이 달랐다
▎ MySQL에 있는 주문 테이블이 계속 바뀐다. 주문 하나가 결제대기 → 결제완료 → 배송중 → 완료로 상태가 변한다. 이 변경분을 HDFS에도 계속 반영해야 하는데, 같은 주문은 최신 상태 하나만 남아야 한다.
이러한 Hudi의 세계관은 테이블에 행이 있고, 같은 데이터를 가진 행이 또 오면 덮어쓰는 Upsert기능이 메인을 이루는 라이브러리인것을 확인했다 데이터베이스의 UPDATE를 파일 더미 위에서 흉내내는 느낌이라고 보면 될것같다
현재 프로젝트에서는 센서 데이터를 주로 다루고 있기 때문에 한번 들어오면 바뀌지않는 특성으로 인해 위와같은 강점에 대해서 쓸일이 없을 거라고 생각했으며, 쓰지도 않을 기능때문에 레코드 키 설계와 인덱스 튜닝을 떠안는건 비효율적이라고 생각했다
다만 Merge-on-Read 모드는 실시간 쓰기를 Avro 로그에 이어붙였다가 주기적으로 parquet에 반영하는 구조라, 소형 파일이 애초에 덜 생긴다는 점은 아까웠다
그래도 라이브러리와의 성격은 맞지않다고 판단되어 해당 기술을 탈락시켰다
Paimon은 "1초에도 수없이 바뀌는 데이터"를 실시간으로 받아내기 위해 만들어진 도구이다
결제대기 → 결제완료 → 배송중 → 완료 이러한 변경이 1초에 수천건씩 쏟아질때 HDFS에 반영하는 용도로 만들어졌으며,
데이터가 들어오면 정리된 곳에 바로 넣지않고 새파일로 우선 쌓은뒤, 백그라운드에서 합치는 LSM 구조로 되어있다
또한 테이블을 Kafka처럼 사용해서 Paimon 테이블에 뭔가 바뀔경우 구독중인 다른 프로그램에 자동으로 소비하는 구조로 만들수도 있다고 한다
현재 내가 하는 프로젝트와 비교를 진행해 봤을때 이점이 없다
| Paimon | 현재 프로젝트 | |
| 데이터 변경 유무 | 1초에 수천번 바뀜 | 센서값은 찍히면 끝(변경 무) |
| 수신 주기 | 끊임 없이 | 30분에 한번 묶음으로 |
| 읽는 주체 | 다른 실시간 프로그램 | Spark |
| 쓰는 엔진 | Flink | Spark |
위와같은 이유로 인해 Paimon도 후보에서 탈락시켰다
결국 실질적인 고민은 Iceberg와 Delta Lake 사이였다
둘다 파일목록을 메타데이터로 관리해서 원자적 커밋과 스냅샷 격리를 얻는다는 취지는 같으면
궁극적으로 paruqet을 복사없이 제자리에서 전환할수 있다는것도 같다는 점이였다
물론 위에서 말한 기술들도 구현할수있지만 그에 맞는 트레이드오프중 비효율적인 면이 커서 후보에서 탈락시켰지만
두개의 라이브러리는 비교해보니 프로젝트 성격과맞고 장단점이 명확해서 고민이좀 되었다
그래도 우선 내가 중점적으로 둔 현재 운영중인 프로젝트이기 때문에 기존에 있던 데이터를 안정적이게 compact 할수있는지
를 기준으로 비교하기 시작했다
우선 분명히 해둘 건, compaction 자체의 안전성은 Iceberg와 Delta가 같다는 점이다
스냅샷 격리, 원자적 커밋, 중간 실패 시 무손실, 적재와 동시 수행, 롤백까지 둘 다 똑같이 제공한다. 앞에서 정리한 문제 네 가지는 어느 쪽을 골라도 해결된다
그래서 갈린 건 compaction이 안전한가"가 아니라 운영 중인 시스템에서 그 전환을 어떻게 밟느냐였다.
여기서 세 가지가 갈렸다
첫번째로 리허설을 할 수 있느냐다
운영 시스템에서 가장 무서운 건 해보기 전까지는 모른다는 것이다. 얼마나 걸릴지, 행 수가 맞을지, 느려질지를 추정으로만 들고 들어가야 한다
Iceberg에는 snapshot 프로시저가 있다
원본 데이터 파일을 참조만 하는 Iceberg 복제본을 만든다. 데이터 복사가 없고, 원본 테이블은 손도 안 댄 채 계속 서비스한다
이 복제본으로 전환 소요 시간을 실측할 수 있고, 대규모 compaction까지 그대로 돌려볼 수 있다
복제본은 gc.enabled=false로 만들어지기 때문에 원본 파일을 실수로 지울 수도 없다. 즉 운영 데이터로, 운영 영향 0으로, 위험한 작업 전체를 미리 돌려볼 수 있다는 뜻이다
Delta는 CONVERT TO DELTA가 제자리 전환만 되기 때문에 이게 안 된다. 테스트 복제본을 만들려면 수십 GB를 물리적으로 복사해야 하고, 복사하는 동안 들어온 데이터는 또 안 맞는다. 결국 운영에서 바로 하되 롤백 계획을 두는 방식이 된다
두번째로 전환이 제대로 됐는지 증명할 수 있느냐다
전환에서 가장 무서운 실패는 파일 몇 개가 조용히 누락되는 것이다. 에러도 안 나고 나중에 학습 결과로만 드러난다. 그래서 29,688개가 전부 넘어왔다는 걸 증명할 수단이 필요했다
Iceberg는 메타데이터를 SQL로 조회할 수 있어서 전환 전후를 바로 대조할 수 있다. 앞에서 손으로 계산했던 파티션당 파일 수도 쿼리 한 줄로 나온다
Delta는 DESCRIBE DETAIL로 총 파일 수와 크기까지는 나오지만, 파티션별 분포를 보려면 _delta_log를 직접 파싱해야 한다
세번째로 대량 재작성을 몇 번 하게 되느냐다
운영 중에 수십 GB를 다시 쓰는 작업은 그 자체가 리스크 이벤트라 횟수를 줄여야 한다
Iceberg는 전환 자체가 데이터를 안 건드리고 메타데이터만 만든다. 그래서 대규모 compaction 한 번이면 끝이다. 나중에 파티션 입도를 바꾸더라도 스펙만 바꿔두면 월 compaction이 돌면서 자연스럽게 수렴하니 추가 재작성이 없다
Delta는 파티션 구조를 바꾸려면 전체 재작성이 한 번 더 필요하다. 운영 중 대형 작업이 한 번 더 생기는 셈이다
반대로 Delta가 나은 점도 분명히 있었다
롤백이 훨씬 단순하다. _delta_log 디렉터리만 지우면 데이터 파일은 손도 안 댔으니 원래 Hive 테이블로 완전히 복귀한다. 이보다 깔끔한 롤백은 없고, 전환 과정에서 Hive Metastore를 건드리지 않는다는 것도 장점이다
그럼에도 Iceberg를 고른 이유는 결국 하나로 모인다
롤백은 이미 사고가 난 뒤에 쓰는 수단이다. 되돌리는 동안에도 서비스는 영향을 받고, 무엇보다 지금 피하려는 사고는 조용한 종류라 롤백할 시점조차 모른다
반면 리허설은 사고 자체를 안 나게 한다. 전환 소요 시간을 실측해서 수신 주기 안에 들어가는지 판단할 수 있고, 행 수 보존도 미리 확인할 수 있다
운영 중인 시스템에서는 되돌릴 수 있다는 것보다 미리 재볼 수 있다는 쪽이 낫다고 봤다
결국 Iceberg가 현재프로젝트에서 도입하기에 최적이라고 생각이 되었기 때문에 Iceberg를 도입하기로 결정했다
Iceberg는 어떻게 동작할까?
[쿼리 엔진: Spark / Trino / Flink]
        │
    [ Iceberg ]   ← 이 계층이 새로 추가된다
        │
[ parquet 파일 (HDFS / S3) ]  ← 실제 데이터는 그대로
지금 사용하는 방식은 테이블이 곧 HDFS 폴더 구조입니다. 년/월/일 이런 식으로 폴더 파티션을 나눠놓았기 때문에, 쿼리를 날리면 Spark가 폴더를 뒤져 파일을 읽습니다.
실제로 들어있는 파일 목록을 그때그때 읽기 때문에 파일을 지우면 즉시 영향을 받게 됩니다. 만약 클라이언트에서 전날 데이터를 읽던 도중 compact 작업이 이루어지면, 조회가 안 되는 불상사가 발생하는 것입니다.
Iceberg 계층을 도입하면 해당 계층의 메타데이터를 먼저 읽고 어떤 파일을 읽을지 결정하게 됩니다.
삭제를 커밋에서 떼어냅니다
그런데 여기서 한 가지 의문이 들었습니다. Iceberg도 결국 compact를 할 때 파일을 다시 쓰는 건 똑같지 않나? 그러면 대체 뭐가 다른 걸까요.
쓰는 일은 정말로 똑같습니다. 소형 파일 86개를 읽어서 큰 파일 하나로 다시 쓰는 I/O는 스크립트든 rewriteDataFiles든 완전히 같습니다. 다른 건 딱 하나, 옛 파일을 언제 지우느냐입니다.
Iceberg에서 compaction은 삭제를 하지 않습니다. 목록에서 빼기만 합니다. 실제 삭제는 완전히 별개의 작업이라고 보면 됩니다.
그래서 커밋 직후에 옛 목록을 들고 있던 쿼리가 옛 파일을 열어도 파일이 그 자리에 그대로 있으니 정상적으로 읽힙니다. 새로 시작하는 쿼리는 새 스냅샷을 잡아서 큰 파일 하나를 읽습니다. 둘 다 맞게 동작합니다.
Iceberg는 이 둘을 분리합니다. "목록에서 뺀다"와 "디스크에서 지운다"가 별개의 행위가 되기 때문에, 전자만 즉시 하고 후자는 안전해질 때까지 미룰 수 있는 것입니다.
그러면 스크립트도 옛 파일을 안 지우고 두면 되지 않나 싶었지만, 폴더에 옛 파일 86개와 새 파일 1개가 둘 다 있으면 Spark는 87개를 전부 읽습니다. 같은 데이터가 두 번 조회가 되는 불상사가 발생할 것이라고 생각했습니다.
전환 방식도 다릅니다. 스크립트는 옛 파일을 지우고 새 파일을 옮기는 사이에 옛 것도 없고 새 것도 제자리에 없는 구간이 생깁니다. 여기 들어온 조회는 에러도 안 나고 그냥 빈 결과를 받습니다. 조용히 틀린 답을 주기 때문에 에러보다 오히려 더 나쁩니다.
Iceberg의 커밋은 메타데이터 포인터 하나를 바꾸는 것이라 중간 상태가 없습니다. 바꾸기 전이면 옛 목록, 바꾼 후면 새 목록이고 그 사이라는 게 존재하지 않습니다.
그리고 쿼리는 시작할 때 스냅샷 ID를 하나 잡는데, 한 번 만들어진 스냅샷의 파일 목록은 절대 바뀌지 않습니다. 폴더를 그때그때 뒤지는 것과 근본적으로 다른 지점입니다.
한 줄로 정리하면, compaction이 하는 일 자체는 똑같고 Iceberg는 삭제를 커밋에서 떼어내 아무도 안 볼 때까지 미룰 수 있게 만든 것입니다. 그게 가능한 이유는 "디스크에 있다"와 "테이블에 속한다"를 분리했기 때문입니다.
그래도 만능은 아닙니다
물론 Iceberg도 만능은 아닙니다. 아래와 같은 단점이 있기는 합니다. 무엇이든지 트레이드오프는 생기니까요.
Iceberg가 compaction 연산 자체를 더 빠르게 또는 싸게 해 주지는 않습니다. 소형 파일을 전부 읽고 다시 쓰는 비용은 스크립트와 똑같습니다
compaction을 없애 주지도 않습니다. 30분 단위 zip이 계속 들어오는 한 소형 파일은 계속 생기므로, 여전히 주기적으로 rewriteDataFiles를 돌려야 합니다
마이그레이션과 운영 복잡도(카탈로그, 라이브러리 반입, 상류 적재 방식 전환)가 공짜가 아닙니다.
하지만 운영 중에 안전하게 데이터를 핸들링하는게 중요하다고 생각했기 때문에 Iceberg를 도입하기로 결정했습니다.
'개발 > 오류 및 고민' 카테고리의 다른 글
| Spark Analysers 도입 (0) | 2026.10.08 |
|---|